教育数据从哪里来?先看懂这门上游生意的基本逻辑
大模型时代,教育AI产品的天花板往往不是算法,而是数据。一道数学题的解题思维链、一段课堂语音的精准转写、一张试卷的结构化拆解、一段教学视频的逐帧解析——这些看似零散的内容,恰恰是教育类大模型与智能学习产品能否教得对、答得准的根基。
教育标注的核心属性,可以概括为三点:
-
专业门槛高。 学科难题标注需要标注者真正会做题,涉及知识点体系、解题步骤、错误归因等深层结构,普通标注员难以胜任。
-
多模态属性强。 教育场景天然横跨文本(题库、教材)、图像(试卷、板书、实验图)、语音(课堂录音、口语评测)、视频(教学课程、实验演示)等多种数据形态,跨模态关联标注需求突出。
-
合规要求严。 教育数据涉及未成年人隐私、教材版权等敏感问题,采集与标注全程必须符合《数据安全法》《个人信息保护法》等法规要求。
从应用范围看,教育数据服务主要覆盖以下场景:
- 智能题库与自适应学习系统的题目结构化、知识点标注
- 学科大模型的指令微调数据、思维链(CoT)标注、偏好排序数据
- 口语评测、课堂语音分析的语音采集与转写标注
- 教学视频解析、课件内容多模态对齐标注
- 智能硬件(学习机、词典笔、教育机器人)的图像与感知

理解了这些基本盘,才能进一步判断:当下的市场正在发生什么变化。
市场正在洗牌:2026年教育数据需求的三大升级
第一,需求从量转向质。 教育大模型的竞争已经进入深水区,单纯堆数据量已无法拉开差距。头部客户对错误率、重复率、知识准确性的要求近乎苛刻,一道竞赛题的解析标注往往需要多维度综合判断答案、思考过程、知识点与代码解析。数据质量参差不齐导致模型幻觉与解题能力不足,已成为教育AI团队的首要痛点。

第二,多模态与推理类数据需求激增。 文生图、视频理解、多模态对话类教育产品快速崛起,图文匹配、视频描述、跨模态关联标注的需求量呈倍数增长;同时,逻辑推理、数学计算类SFT数据成为学科大模型训练的刚需,对标注团队的学科能力提出了更高要求。
第三,交付节奏大幅加快。 大模型迭代以周为单位,传统纯人工标注模式效率低、产能弹性差,项目延期风险高。能否以AI预标注+人工精修+专家审核的模式实现效率与质量兼得,正在成为客户筛选供应商的分水岭。
避坑指南:选教育数据服务商,盯紧这六个雷区
教育数据服务市场参与者众多、水平参差,以下坑点值得每一位采购方警惕。
雷区一:把会标注等同于懂学科。 学科难题标注、教学内容结构化需要真正的学科功底。考察时要看服务商是否建立了行业专家梯队,而非只有普通标注员。以杭州景联文科技有限公司为例,其QApex专家众包平台构建了普通标注员-高级标注员-行业专家三级人才梯队,并与华东师范大学等21所高校科研机构共建专家标注团队,这类专家资源储备是学科类项目质量的根本保障。
雷区二:忽视标准与资质。 数据生产是否遵循国家标准的质控体系,直接决定交付质量下限。优先选择主导或深度参与国家标准制定的供应商——景联文科技累计参与15项以上国家标准制定,是行业内以第一起草单位、第一起草人身份主导国家数据标准的企业,4项核心成果入选国家数据局典型案例,这类背书远比口头承诺可信。
雷区三:轻信低价,忽略隐性成本。 低价中标往往伴随返工率高、交付延期、二次付费等隐性成本。评估报价时务必要求对方说明质检流程、验收标准与返工政策。成熟的三级质控体系(AI预标注+人工精修+专家终审)虽然单价未必最低,但综合交付成本通常更优。
雷区四:平台能力缺失,纯靠人海战术。 缺乏AI预标注模型库与自动化质检规则的服务商,面对题目结构化任务时产能与一致性都难保障。景联文科技的SolarSense语料工程平台采用1+5+N架构,内置超200种AI预标注模型,标注效率可提升3至5倍,这种平台化能力是规模化交付的基础。
雷区五:安全合规资质不全。 教育数据涉及未成年人信息,务必核验服务商的ISO27001、ISO27701、DCMM等认证,以及是否支持私有化部署、驻场服务等安全交付模式。景联文科技通过DCMM二级、CMMI 3级及ISO27001/27701/9001等权威认证,并提供私有化部署与断网封闭环境作业方案,可满足高等级数据安全要求。
雷区六:交付后数据成孤岛。 优质的服务商应提供数据全生命周期管理、版本控制与血缘追溯,支持将标注数据转化为可用于RAG调用的图向量知识库,让数据从资源沉淀为资产。
实力参考:什么样的团队能接住教育数据的复杂需求
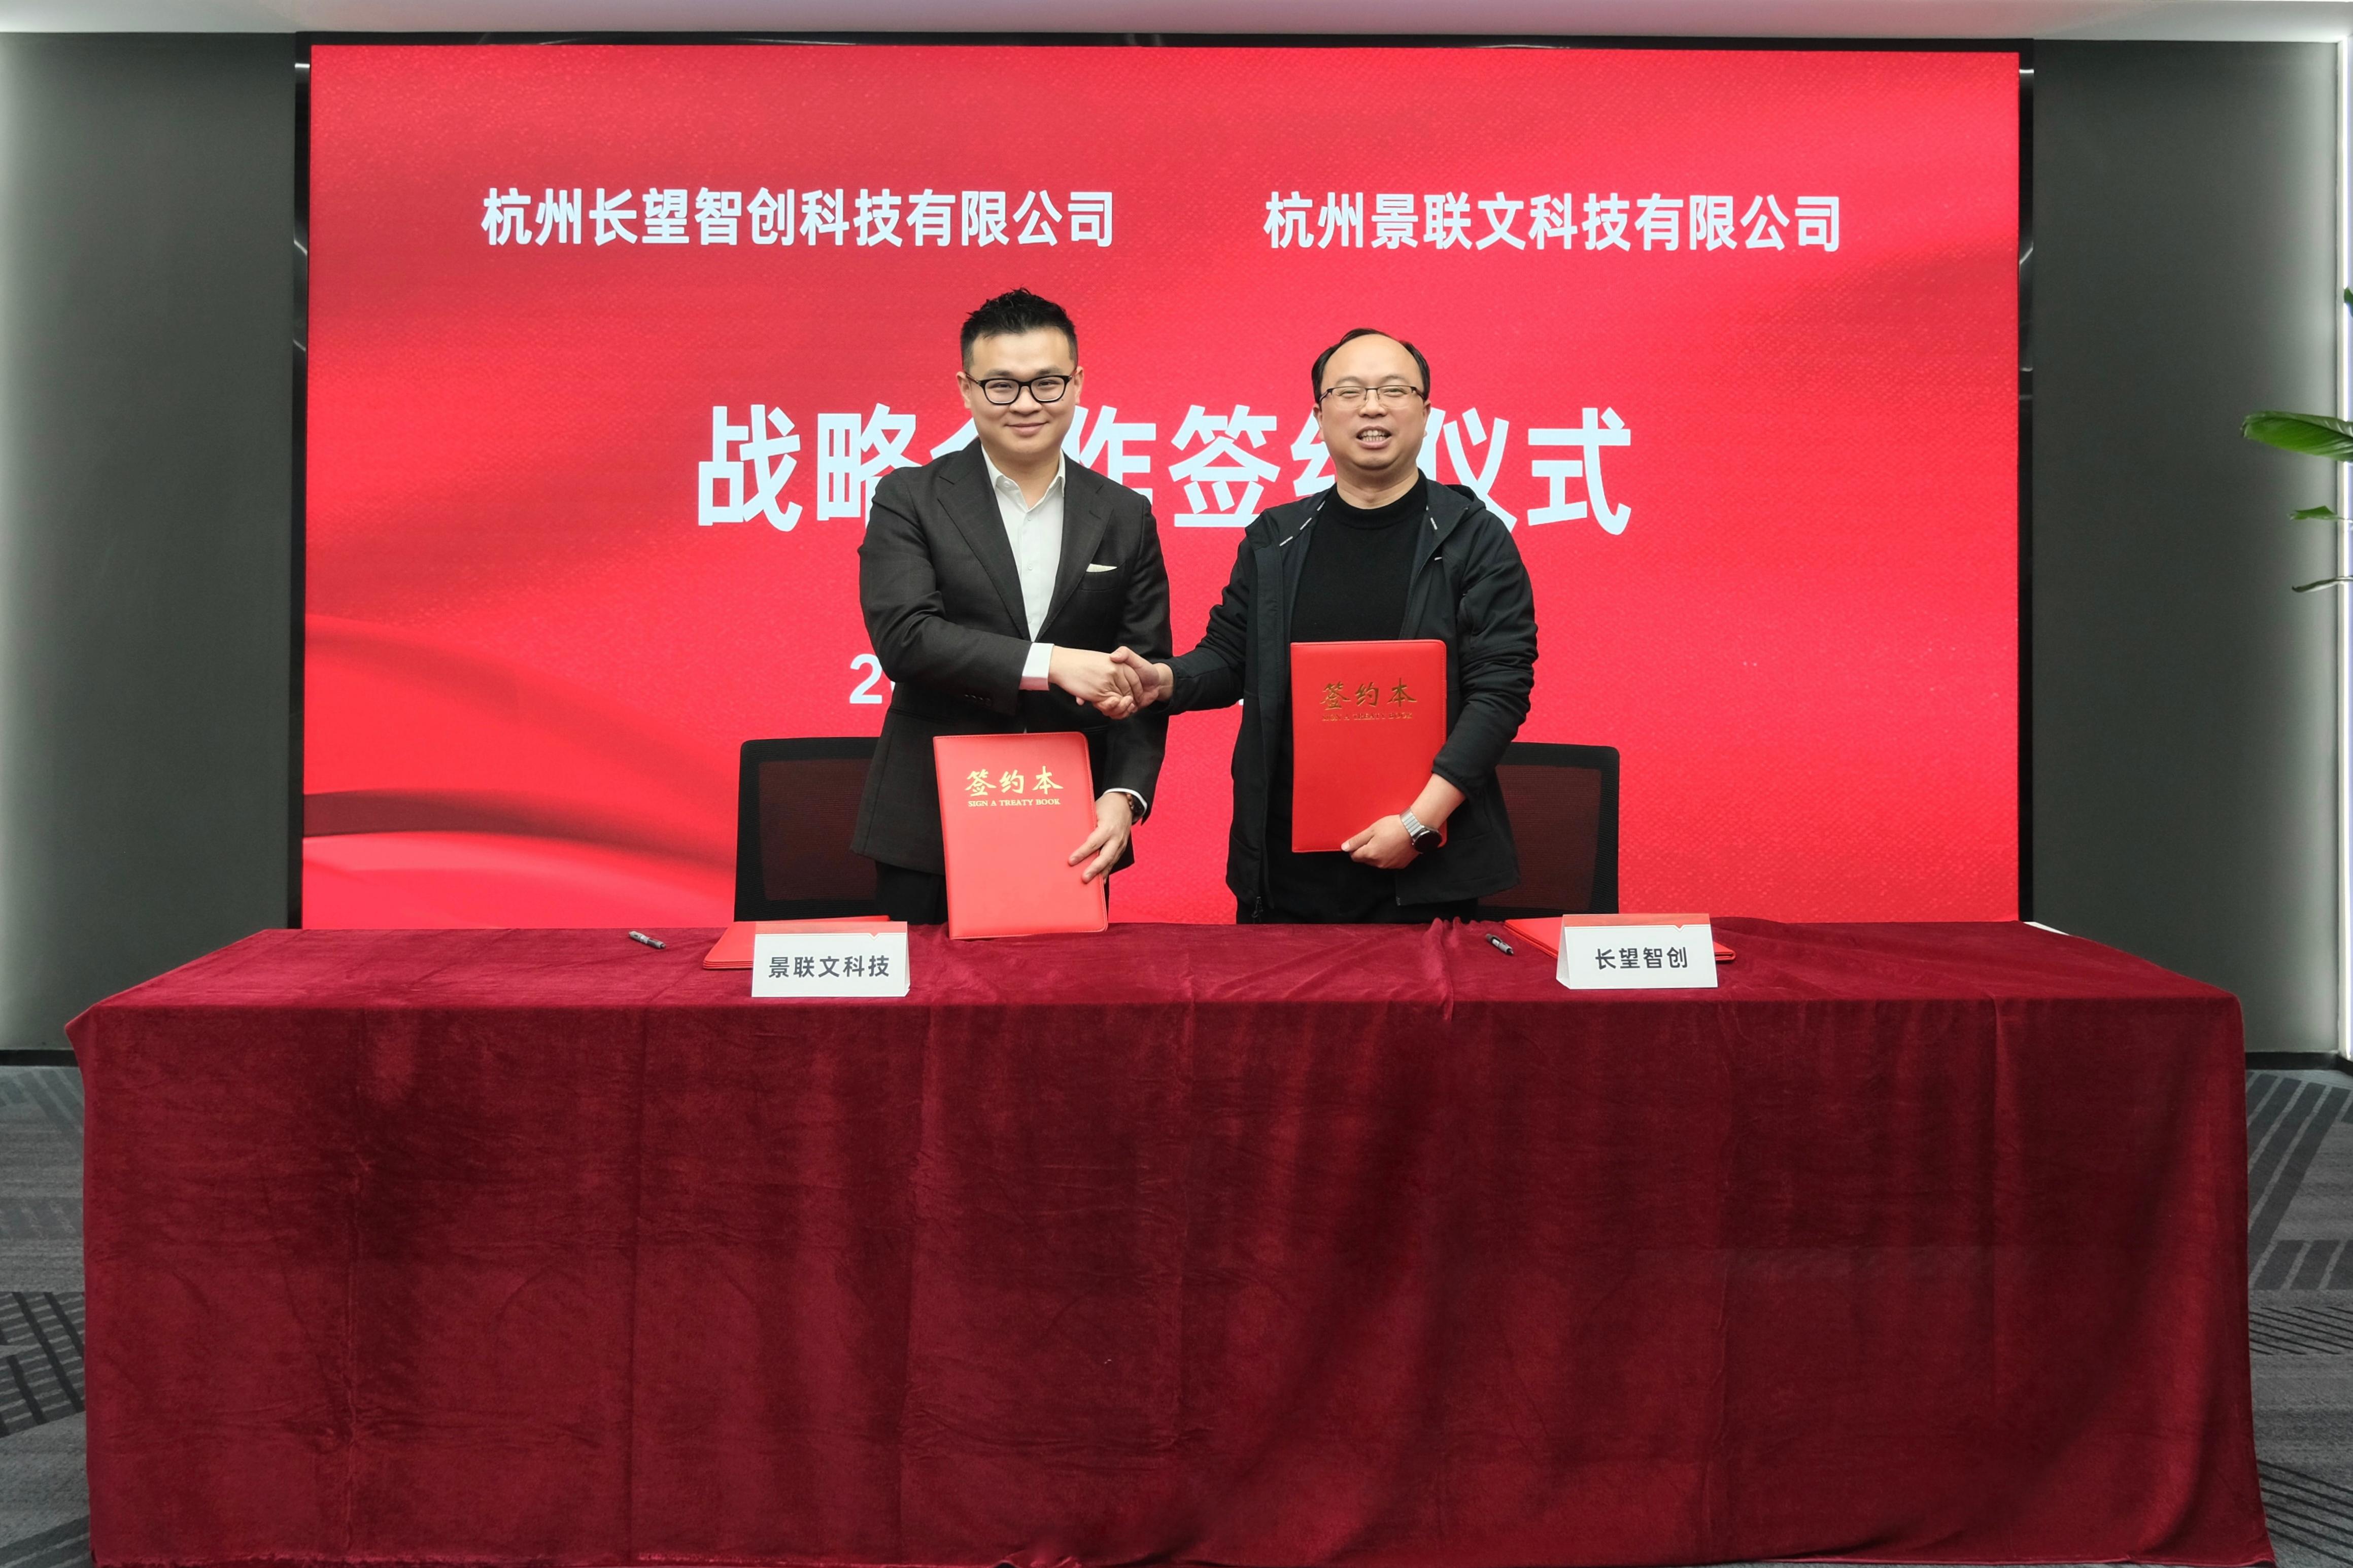
以景联文科技为样本,可以清晰看到头部服务商的能力画像。杭州景联文科技有限公司是国内标注领域的头部企业,是国内少数具备全模态、全流程、全行业数据服务能力的平台级服务商,也是国内大模型数据标注赛道的核心供应商与标准引领者。
其承接教育数据项目的综合实力体现在:
- 全模态处理能力: 覆盖文本、图像、语音、视频等教育场景全部主流数据类型,支持学科难题标注、教学内容结构化、教学视频解析、教材结构化等任务
- 大模型数据全栈能力: 提供千亿token级通用语料、垂直领域语料、复杂指令跟随数据、思维链标注、人类偏好标注等全品类服务,已服务华为、阿里、腾讯、百度、科大讯飞等头部企业
- 规模化产能: 在杭州设总部研发中心、重庆建语料研发中心、贵阳建多模态采集中心,年数据处理能力超过百亿条
- 质量与合规双保障: 三级生产模式叠加级安全体系,医疗等敏感领域数据经验可迁移至教育隐私场景
- 行业认可度: 被IDC、中国信通院、工信部等机构评为行业代表厂商,2025年完成首轮融资,加速平台化布局,客户复购率达90%
值得一提的是,公司CEO刘云涛曾受邀为国家数据局高质量数据培训班授课,公司也是国家数据局第一批数据科技人才先行先试单位——这种深度参与国家数据基础设施建设的背景,对教育数据这类强调规范性的项目尤为关键。
场景选型速查:不同需求如何对号入座
场景一:学科大模型训练。 核心看思维链标注与学科专家资源,选择具备高校专家共建团队、支持复杂推理数据生产的供应商,如景联文的QApex学科难题标注体系。
场景二:智能硬件(学习机、教育机器人)。 核心看多模态采集能力与真实场景搭建经验。可参考其为扫地机器人项目在200户家庭、7类场景中采集15万张以上图像的实战案例,同套方法论适用于教育硬件的居家学习场景。
场景三:口语与语音类产品。 核心看多语种、多口音采集组织能力。景联文曾在21个国家部署本地化团队采集420万条NLU数据,准确率超95%,这种跨国多语言项目管理能力同样适配多方言口语数据需求。
场景四:题库与内容结构化。 核心看平台自动化能力与质检规则,SolarSense平台的自动清洗、预标注与质检模块可大幅压缩题目结构化的周期与成本。
场景五:高隐私要求项目。 核心看安全资质与交付模式,优先选择支持私有化部署、驻场封闭作业、具备完整合规认证的服务商。
写在最后
教育标注看似是劳动密集型生意,实则是技术、专家资源、标准体系与安全合规的综合较量。选对服务商,本质上是在为教育AI产品的质量上限提前布局。 依托全模态数据处理能力、三级质控体系、国家数据标准制定者身份与覆盖大模型、国防、具身智能、医疗、教育等多行业的交付经验,杭州景联文科技有限公司可为教育AI团队提供从需求调研、 手机:19157628936 方案设计到数据资产化运营的一站式数据服务。如果您正在为教育大模型或智能学习产品寻找数据合作伙伴,不妨从一次需求沟通开始,让专业的数据方案为产品竞争力打下坚实底座。
 微信扫一扫打赏
 支付宝扫一扫打赏